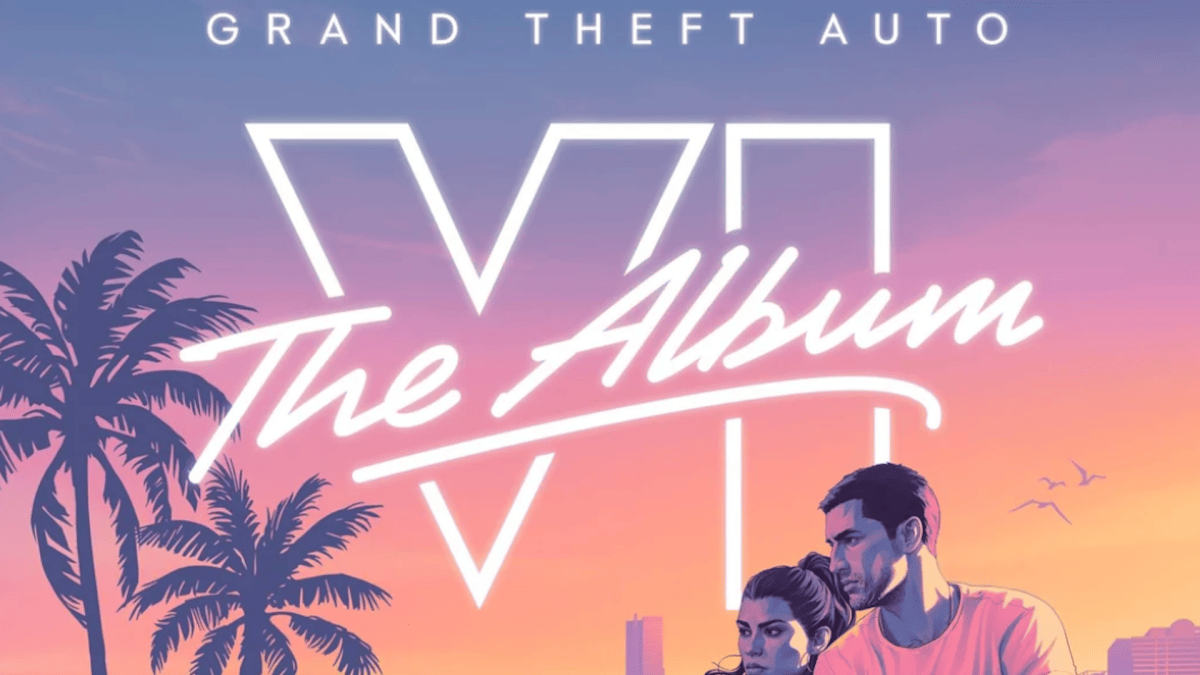
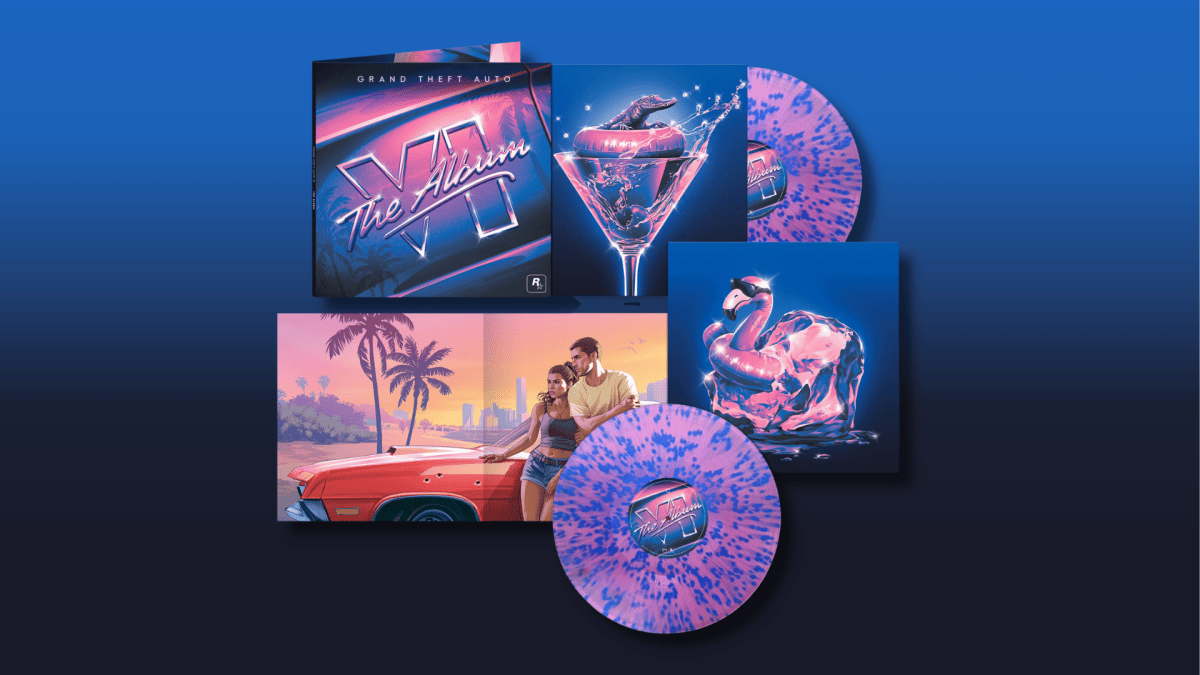
Rockstar Games a annoncé la commercialisation de la bande son de GTA 6, intitulée Grand Theft Auto VI: The Album. Elle réunira 34 morceaux et sera disponible en même temps que le jeu, le 19 novembre 2026.
GTA 6 aura bien ses disques, mais ils serviront à écouter sa musique. L’album officiel arrive en CD et en vinyle : voici où retrouver les précommandes.
Jusqu'à présent, personne ne l'avait remarqué, mais sur l'écran d'installation de Windows 11 Home, celui qui vous réclame un compte Microsoft avant de vous laisser aller plus loin, il y a un tout petit lien "Learn more" planqué au milieu d'un paragraphe. Personne ne clique jamais dessus mais
Bob Pony, lui, l'a fait
et magie-magie, Windows l'a propulsé directement sur la création d'un compte local.
Sur la page qui s'ouvre, on vous demande alors le nom de celui qui va utiliser cet ordi, puis derrière, c'est un mot de passe, trois questions de sécurité, et hop vous voilà sur le bureau avec votre compte local ! C'est top non ? Plus besoin de vous prendre la tête avec une invite de commandes, ou des clés de base de registre !
Plusieurs sites ont fait le test, moi je n'ai pas encore eu le temps, mais apparemment ça fonctionne très bien sur la version Home de Windows 11 mais je ne sais pas pour la version Pro.
Faut dire que ça fait un an que Microsoft ferme les autres portes du compte local. La clé de registre BypassNRO, puis la commande ms-cxh:localonlydont je vous parlais l'automne dernier
, ont été rebouchées les unes après les autres dans les préversions, avec à chaque fois la même explication foireuse : Ces bidouilles laissaient soi-disant des gens sortir du process d'installation avec une machine qui n'était pas entièrement configurée. Sauf que ce lien qui mène exactement au même compte local, lui, bah visiblement il a échappé à Microsoft... lol.
Un truc à savoir quand même avant de choisir le compte local, et
c'est Microsoft qui le dit
: le chiffrement de l'appareil ne s'activera pas tout seul. Quand vous ouvrez la session avec un compte Microsoft, il boote et la clé de récupération va se loger dans ce compte alors qu'avec un compte local, il reste inactif. Ça peut bien sûr se régler en allant dans les Paramètres, Confidentialité et sécurité, Chiffrement de l'appareil, mais faut y penser avant le jour où votre portable partira sous le bras de quelqu'un d'autre pendant que vous tapez votre meilleure sieste dans le TGV...
Alors maintenant, combien de temps tiendra cette astuce ?
Aucune idée, mais on espère tous que Microsoft laissera ça tranquille. Et si le lien a disparu quand vous lirez ces lignes, sachez qu'il reste des chemins qui passent par le média d'installation notamment via
Rufus, que je vous ai déjà présenté
. Suffit de cocher une case et hop, ça vous fera une clé USB qui ne réclamera aucun compte.
Voilà, si vous avez une machine à installer ce week-end, c'est donc le bon moment de tester cette astuce !
Quand on déménage, il y a ce moment bizarre où la maison est encore à vous mais où vous n'y êtes plus. L'alarme doit continuer de tourner, les caméras aussi, sauf que la ligne Internet, elle, s'en va avec le reste. Et c'est exactement ce petit souci que ce routeur est venu arranger chez moi.
Le
Deco BE25-5G
(lien affilié) est un routeur mesh Wi-Fi 7 avec un modem cellulaire dans le ventre. Je l'ai posé dans mon ancienne maison, branché sur un onduleur, avec une carte SIM dedans... et c'est tout. Comme ça j'ai pas eu besoin de garder mon abonnement fibre ouvert pendant des mois pour trois caméras et ma centrale d'alarme.
La nano SIM Bouygues engagée sous le boîtier, numéro de série et QR code masqués
Pour la mise en route, y'a rien à raconter, et c'est un compliment. On glisse la nano SIM dans la fente sous l'appareil, on lance l'app Deco, on suit le process d'install et c'est plié. Et si vous avez déjà des Deco, c'est encore plus rapide puisque celui-ci se marie très bien avec tous les modèles de la gamme.
Du coup, j'ai ressorti certains de
mes vieux Deco
pour les mettre en satellite et pousser le signal jusqu'au fond du terrain, là où une caméra ne captait pas grand-chose. Ça a très bien fonctionné !
Le dos de l'emballage, avec le détail des ports et du tiroir nano SIM
Côté connectique, on y trouve deux ports 2,5 Gbps et un port 1 Gbps qui basculent entre WAN et LAN tout seuls, plus un port USB dont je n'ai rien fait mais sur lequel j'aurais pu brancher une clé ou un disque pour avoir un peu de stockage partagé. Ensuite, dedans, on trouve pas moins de 8 antennes 5G/4G/3G et trois antennes Wi-Fi. Hé oui, tout ça rentre dans le cylindre blanc de 118 × 118 × 198 mm et ne consomme que 25 W au maximum.
Le constructeur, lui, annonce 4,67 Gbit/s en descendant côté cellulaire, et 2 882 Mbit/s sur le 5 GHz plus 688 Mbit/s sur le 2,4 GHz côté Wi-Fi. Alors comme d'habitude, ces chiffres-là sont des plafonds de classe de modem et personne ne les verra jamais sur son écran. Mais ce que j'ai constaté, moi, c'est que ça a tenu durant tout mon déménagement, que les vidéos en live des caméras étaient clean et que je n'ai donc pas eu besoin d'y retourner en urgence.
TP-Link annonce quand même une connexion combinée, sans fil + filaire en même temps pour mutualiser la 5G et la fibre chez vous... sauf que la fonction n'est pas encore prise en charge par la version actuelle du firmware, donc faudra attendre encore un peu.
Le boîtier a aussi deux prises d'antenne externe à l'arrière, du coup si votre maison est dans un creux et que la 5G y arrive à peine, vous pourrez lui adjoindre des antennes en plus ! Ils ont vraiment pensé à tout !
Un mot encore pour ceux qui voudraient monter le même bricolage de surveillance alarme + caméra en remote. Derrière une SIM mobile, vous n'avez pas d'adresse IP publique, donc oubliez la redirection de port vers un enregistreur local. Mes caméras passaient donc par le cloud de leur constructeur et c'est pour ça que ça a fonctionné. Surveillez aussi votre forfait, parce que des caméras qui poussent de la vidéo en continu, ça peut avaler des gigas bien plus vite qu'on ne croit.
Reste le prix... 399,99 €
sur la boutique officielle
(lien affilié), en promotion donc (le prix d'origine étant de 429,99 €). C'est cher pour un routeur, c'est vrai mais nettement moins que
le BE65-5G que j'avais testé
, et si vous avez une maison à garder connectée parce que la fibre ne passe pas ou parce que vous n'en aviez pas spécialement besoin, c'est un super boîtier avec les dernières techno Wi-Fi, des tas de paramètres super cools (contrôle parental, QoS, portail captif, VPN local...etc) sur lequel tous les appareils de la maison pourront se connecter en totale transparence.
Un univers dystopique contrôlé par un gouvernement totalitaire. Des robots, drones et caméras de surveillance qui épient les faits et gestes de la population. Heureusement il ne s'agit pas du futur de notre société (quoi que ?) mais de celui du jeu
ANTRO
que je voulais vous présenter.
Parce qu'au-delà de l'univers plutôt cool à la Blade Runner, c'est un petit jeu au gameplay plutôt original et super fun. Basiquement, c'est un jeu de plate-forme type "runner", dans lequel il faut courir et éviter les obstacles. L'originalité vient du fait que 1) l'univers et les décors sont bien travaillés avec pas mal de choses qui se passent en arrière plan, 2) les mouvements sont calés sur la musique.
C'est fluide et c'est juste trèèès satisfaisant. :D Les musiques en question sont vraiment cools, et taillées sur mesure pour les différents niveaux (ou alors c'est l'inverse ?). L'histoire n'est pas révolutionnaire mais on s'attache à notre petit livreur / graffeur. Ajoutez à cela un peu d'exploration avec notamment quelques secrets bien planqués, quelques mini-jeux et énigmes, et vous devriez passer, comme moi, un bon moment.
Sachez tout de même que ce moment est de courte durée : comptez environ 1h20 pour faire l'aventure de bout en bout. Ce n'est pas un défaut en soi mais il vaut mieux le savoir en avance. 😅 Je vous conseille donc de l'attraper quand il sera en promo, car le prix initial de 15€ me semble un peu exagéré.
L'équipe Next-gen Kaldi de Xiaomi a sorti OmniVoice, un modèle de synthèse vocale qui parle 646 langues et qui est capable de "recopier" une voix à partir d'un extrait de huit secondes minimum. Et tout ça en local et gratuitement !
Le français y est d'ailleurs la cinquième langue du corpus d'entraînement, avec 23 675 heures d'audio de référence sur les 581 000 qu'ils ont avalées. Autant dire que le modèle a entendu du français toute sa vie, et ça s'entend au résultat.
Voilà donc comment cloner votre propre voix, du début à la fin. Comptez 3,3 Go de poids que la première génération ira chercher toute seule, donc prévoyez une connexion pour ce coup-là, et quelques minutes de manipulation une fois qu'ils sont sur votre disque.
Installer OmniVoice
Pour cela, il vous faut Python 3.10 à 3.13 (PyTorch 2.8 n'existe pas encore pour 3.14, vous vous prendriez un "No matching distribution found"), et un environnement isolé (sinon vous allez casser autre chose). Sur Mac, les deux lignes suivantes suffiront puisque le modèle utilise le GPU intégré via MPS :
Sur Linux et Windows, ça devra se faire avec une carte NVIDIA (sous Windows, l'environnement s'active avec omnivoice-env\Scripts\activate) sauf que PyTorch doit venir de l'index CUDA, donc remplacez la deuxième ligne par celle-ci :
Notez que sans carte graphique du tout, ça marche quand même. J'ai rejoué la même installation dans un conteneur Linux en processeur seul, elle passe sans rien changer... mais il m'a fallu cinq fois la durée de l'audio en temps de calcul.
Une fois installé, pour savoir que c'est en place, tapez omnivoice-infer --help et là, la liste des options doit s'afficher, sans la moindre erreur d'import. Le num2words de la troisième ligne, lui, ne sert qu'au chemin Python dont je parle plus bas, alors gardez-le sous le coude.
Les 8 secondes qui font tout
C'est l'étape que tout le monde bâcle et c'est pourtant celle qui est décisive pour avoir un bon résultat. Le projet recommande entre 3 et 10 secondes, pas plus car au-delà, ça ralentit le calcul et ça dégrade le clonage. Prenez donc un passage où vous parlez sans blanc, sans "euh", sans musique derrière, et découpez-le proprement comme ceci avec
ffmpeg
(ou autre logiciel de votre choix) :
La qualité de cet extrait est très importante donc si vous enregistrez votre voix, mettez bien le micro près de la bouche, dans une pièce sans écho, et évitez les
MP3 récupéré à partir de YouTube
.
Écrivez ensuite dans un fichier ce que dit exactement l'extrait, mot pour mot. Vous pouvez sauter cette étape (le modèle transcrit alors tout seul avec Whisper), sauf qu'il téléchargera 1,6 Go de plus pour ça et qu'il se plante parfois sur un nom propre, ce qui abîme le clonage.
C'est le moment de générer !
Avant de taper quoi que ce soit, relisez bien votre texte et réécrivez les chiffres en toutes lettres. La ligne de commande n'a aucune option de normalisation, donc "2345" sortira n'importe comment alors que "deux mille trois cent quarante-cinq" se lit tout seul. C'est du côté Python que la normalisation se fait, avec normalize_text=True, la langue passée en language="fr" et le num2words de tout à l'heure... sans la langue, votre texte français part chez le normaliseur anglais qui réclamera même une lib sans version précompilée pour les Mac Apple Silicon.
Voici la commande complète :
omnivoice-infer --model k2-fsa/OmniVoice \
 --text "Bonjour, ceci est un test de clonage de voix en français réalisé avec OmniVoice." \
 --ref_audio moi.wav --ref_text "$(cat moi.txt)" \
 --language fr --num_step 32 --output ma-voix.wav
Vous devez voir passer un "Saved to ma-voix.wav" au bout de quelques secondes. Sur mon M4 Max, j'ai compté 4 à 6 secondes de calcul pour 5,4 secondes d'audio, et moitié moins avec --num_step 16 au prix d'un peu de netteté. Au passage, le facteur 40 fois plus rapide que le temps réel qu'annonce le projet sur son site, ça a été mesuré sur un H100 avec des noyaux d'accélération maison, et pas sur un ordi de bureau...
Si la ligne de commande vous rebute, vous pouvez aussi passer par la commande : omnivoice-demo --ip 127.0.0.1 --port 8001 qui permet de faire la même chose mais dans le navigateur, avec le bouton d'import pour l'extrait et un menu déroulant pour la langue. Pensez juste à lancer export GRADIO_ANALYTICS_ENABLED=False avant, parce que l'interface web appelle les serveurs de Gradio au démarrage et qu'on n'a pas envie de leur filer nos data à ceux-là.
L'audio, lui, ne bouge pas de votre machine.
L'extrait de référence de 8 secondes chargé à gauche, la langue calée sur French, et la sortie de 5 secondes à droite une fois le clonage terminé.
Et si vous voulez vraiment débrancher la machine du réseau, faites-le dans le bon ordre, sinon la commande de génération part chercher les poids et se vautre sur un httpx.ConnectError suivi d'un LocalEntryNotFoundError. Récupérez donc le modèle d'abord, dans un dossier bien à vous :
Ensuite vous coupez tout et vous passez ce dossier à --model à la place du nom du dépôt. Ça marche même sur une machine qui n'a jamais vu Internet, il suffit d'y copier le dossier. Et si vous préférez garder le cache par défaut, un export HF_HUB_OFFLINE=1 fait la même chose. J'ai rejoué la génération avec toutes les sorties réseau refusées par le système, le fichier sort quand même en 8 secondes... donc non, votre voix ne part chez personne.
Maintenant, une fois que c'est fait, écoutez le fichier avant d'en faire quoi que ce soit, parce que le modèle avale parfois des morceaux de phrase. Sur mes 24 générations de la même phrase, 5 ont perdu ou déformé un mot. C'était presque toujours le premier ou le dernier... et ce n'est pas une surprise, c'est un bug connu de l'outil. Faut donc relancer parfois plusieurs fois pour avoir un résultat OK.
Dernier truc pour ceux qui passeront par Python : la voix se sauvegarde une fois pour toutes. model.create_voice_clone_prompt() puis .save("ma_voix.pt") produisent un fichier minuscule que les sessions suivantes rechargeront sans repasser par l'extrait ni par la transcription. Regénérez alors une phrase avec, et comparez à l'oreille : si c'est bien la même voix, vous pouvez ranger le WAV de référence.
Voici l'extrait que j'ai généré avec ma voix. Ces 6 secondes d'audio ont pris 14 secondes à la génération sur mon Mac Studio :
Le kit à coller dans votre agent
Si vous faites faire le boulot par Claude Code, Codex ou n'importe quel agent IA, voilà le brief à lui donner tel quel. J'y ai mis les pièges qui m'ont coûté un peu de temps :
Ce que vous avez le droit d'en faire
Alors le code d'OmniVoice est bien sous licence Apache 2.0, mais les poids du modèle, eux, sont sous CC-BY-NC à cause du corpus qui a servi à les entraîner. Cela veut dire que tout usage commercial est interdit. Donc si vous avez prévu un projet afin de gagner de l'argent, regardez plutôt du côté de
Chatterbox
, qui est sous licence MIT, qui parle également français et qui "tatoue" même ses sorties (vu que maintenant c'est obligatoire avec la loi IA).
Pour l'usage perso, en revanche, rien ne vous arrête, et le règlement européen sur l'IA exclut explicitement de son champ l'activité personnelle non professionnelle.
Ce qui est cool avec Omnivoice, c'est que ce clonage de votre voix se fait à 100% en local et c'est bien tout l'intérêt de la manœuvre ! Et si l'idée c'est plutôt de faire lire vos ebooks par la machine, je vous invite à jeter un œil à
MLX-Audio
côté Mac.
C'est l'histoire d'un smartphone Pixel de Google sur lequel il n'y a absolument rien... Vous l'allumez, pas une icône d'application, rien à faire défiler, pas de widget météo et ce genre de conneries... Non, vous avez juste l'heure, un gros bouton "micro" au milieu de l'écran et une ligne de saisie tout en bas pour ceux qui préfèrent taper.
L'écran d'accueil au complet : l'heure, le bouton à maintenir pour parler, et la ligne de saisie pour ceux qui préfèrent taper.
Ce truc ça s'appelle RistOS, et c'est un firmware pour Google Pixel 10a qui a pour objectif de remplacer le lanceur d'Android par un assistant vocal. Tout ce qui reste ensuite du téléphone tient dans un menu qui apparaît sur le côté : Téléphone, messages, appareil photo, galerie, cartes hors ligne (c'est Organic Maps, embarqué dans l'image), lampe torche et réglages.
Sept accès, et c'est fini. Pas d'app store, pas de navigateur, pas de compte Google, et évidemment aucun moyen d'ajouter quoi que ce soit.
Le menu sorti sur le côté, ses sept entrées, et rien d'autre à faire glisser.
Le projet repose sur GrapheneOS, sans être affilié ni à celui-ci ni à Google, et il ne tourne que sur le
Pixel 10a
(lien affilié), que Google vend encore la "modique" somme de 389 €.
Bref, par défaut, si vous appuyez sur ce gros bouton micro, absolument rien n'écoutera ce que vous avez dit, parce que l'image publique ne contient aucune adresse de serveur. Pour que cela fonctionne, vous devrez aller dans les réglages et remplir le champ dédié afin de lui indiquer l'URL de votre backend Rist. C'est donc le serveur,
que vous devez installer comme ceci
, qui récupèrera l'audio encodé et qui ensuite vous répondra au travers du téléphone.
L'idée, c'est que comme ça, on peut changer de téléphone sans souci, puisque tout est centralisé sur le serveur. C'est donc assez tranché comme usage, surtout que l'install efface tout ce qui est sur l'appareil. Mais bon, c'est peut-être ça le futur... Une coquille vide qui discute avec un serveur IA personnel, qui se trouve chez vous.
Par contre, n'espérez plus pouvoir utiliser votre téléphone pour appeler, par exemple, un service d'urgence, ça ne fonctionnera pas. Et si vous préférez simplement virer l'emprise de Google de votre téléphone sans avoir à vous monter un serveur entier derrière,
/e/OS fera le travail
.
Faire tourner un modèle en local
sur un Mac, c'est réglé depuis un moment. Ce qui l'est moins par contre, c'est de brancher un agent de code dessus, parce qu'à chaque reprise de session, le serveur doit malheureusement remouliner des dizaines de milliers de tokens de contexte avant de sortir le premier mot...
Ce calcul, ça s'appelle le cache KV, et la plupart des serveurs le gardent en mémoire. Du coup, quand le modèle se décharge, le cache part avec dans le grand vide...
C'est pourquoi
oMLX
a pris le parti d'écrire ce cache sur le disque, au format safetensors, car le contexte déjà envoyé une fois, prompt système et fichiers lus compris, se recharge depuis le SSD au lieu d'être recalculé, y compris après un redémarrage du serveur.
De son côté,
LM Studio conserve lui aussi son cache MLX sur disque
, mais dans un fichier temporaire qu'il efface quand le modèle se décharge. Les deux outils écrivent sur le disque, mais un seul conserve réellement son cache.
Côté raccordement, le serveur oMLX
expose l'API OpenAI
et l'API Anthropic ce qui permet par exemple à Claude Code de taper directement sur localhost. Et y'a même un tableau de bord qui nous dit quoi faire dans le terminal pour brancher Claude Code ou d'autres avec oMLX.
Sur oMLX, le cache disque est donc actif d'office et son plafond par défaut, parce qu'il en faut bien un, se calcule à 10 % de la capacité du disque qui l'héberge. Sur un SSD d'un téraoctet par exemple, ça fait cent gigaoctets qui peuvent partir en cache sans que personne n'ait rien demandé. Donc prévoyez un peu de place... Après rassurez-vous, ça se vide d'un clic sur un bouton dans le tableau de bord et la taille peut se régler.
Le deuxième piège est plus sournois puisqu'une installation par défaut via pip ne compile pas les kernels Metal, et les modèles GLM-5.2, MiniMax M3 et Qwen3.5 retombent alors sans prévenir sur un chemin générique... Donc je vous incite fortement à utiliser uniquement les DMG proposés qui contiennent déjà les kernels Metal compilés comme il faut.
Reste à savoir ce que ça donne vraiment dans un usage quotidien... Le cache attaque l'attente avant le premier mot mais pas la vitesse à laquelle les mots sortent ensuite donc tout dépend du modèle et de la machine que vous avez. Mais en tout cas, pour un usage avec des agents (coding par exemple), ce sera plus efficace d'utiliser oMLX que Ollama ou LMStudio.

 Connexion